LINEミニアプリの中でMLレコメンドを届ける
LINEだけで完結する物件探しプラットフォームの裏側——Goバックエンド、LIFFミニアプリ、XGBoost推論サービス、そしてレコメンドを新鮮に保つバッチパイプライン。
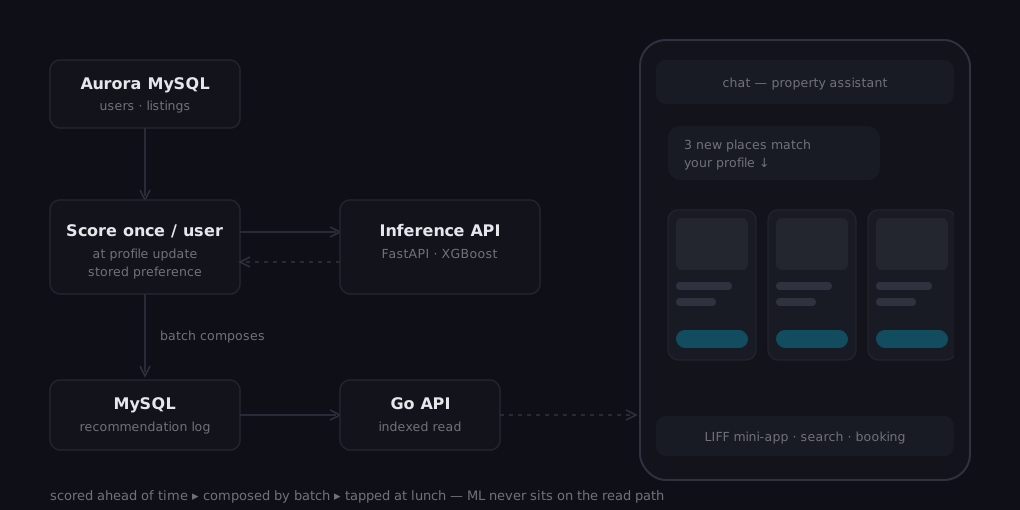
レコメンドシステムを動かしているものは何かと聞かれたら、正直な答えは「ほとんどはモデル以外」です。私が作ったこのシステムで一番誇れるのはスコアリングではありません——誰かが尋ねるずっと前に計算されたスコアが、昼休みのチャットスレッドで誰かがタップするカードへと、確実に変わっていくこと。その経路——スコアからメッセージへ、安く、確実に、チャットプラットフォームの制約の内側で——にこそ、エンジニアリングの大半が住んでいます。
私はLINEだけで提供される不動産ディスカバリープラットフォームのバックエンドを構築・運用しました。ネイティブアプリなし、エンドユーザー向けの独立したWebサイトもなし。検索、お気に入り、内見予約、パーソナライズされた物件レコメンドのすべてが、チャットとLIFFミニアプリの中に住んでいました。レコメンドの経路が実際にどう動いていたかを、端から端まで。
全体アーキテクチャ
4つのコンポーネント、それぞれ仕事は1つ:
| コンポーネント | スタック | 役割 |
|---|---|---|
| メインバックエンド | Go / Echo | LIFFアプリ向けの約60のRESTエンドポイント。ユーザー・物件・予約を所有 |
| 推論サービス | Python / FastAPI / XGBoost | ユーザー属性をスコアリングし、保存される嗜好プロファイルへ |
| 管理パネル | PHP / Laravel | 社内運用:物件、予約、スタッフ |
| バッチジョブ | Go on ECS(スケジュールタスク) | レコメンドの事前計算、通知キャンペーン、マスターデータ取込 |
データはAurora MySQLに。インフラはECS Fargate、ALB+WAF、CloudFront、すべてTerraform管理で、物件データと予約同期のために外部の物件管理システムと認証付きRESTで連携していました。
Go/Pythonの分割は意図的です。データサイエンス側はPythonのエコシステムを必要としました——モデルはXGBoostで、ユーザーのデモグラフィック、地理、インタラクション履歴で学習します。プロダクト側はAPIティアにGoの並行性とデプロイの単純さを必要としました。境界を*「推論サービスはスコアを付け、バックエンドが決める」*に引いたことで、両チームとも速く動けました。
なぜ埋め込みではなく勾配ブースティングか
カタログは新築物件でした:アクティブな物件は数千件、それぞれが構造化された属性(立地、価格帯、間取り、デベロッパー、竣工時期)を豊富に持ちます。ユーザーも構造化された属性を持って現れます——家族構成、勤務地エリア、予算のシグナル。これはテーブルデータのマッチングの領分で、エンジニアリングされた特徴量の上の勾配ブースティング木は、この種のデータでは洒落た手法に勝ち、しかも説明可能で再学習が安い。
(ユーザー, 物件)ペアの特徴量ベクトルは以下の組み合わせです:
- ユーザー属性 — デモグラフィック、明示された希望条件、生活圏の地理
- 物件属性 — 価格、広さ、駅距離、竣工タイミング
- 交差特徴量 — シグナルの大半を運ぶ掛け合わせ:予算適合、通勤地理のマッチ、間取り×世帯人数
- 行動シグナル — お気に入り、閲覧物件、内見履歴
コールドスタート——家は毎週買うものではないので、ほとんどのユーザーが該当します——は属性マッチングだけに優雅に退行します。まさに木モデルが得意とする領域です。
リクエスト時にスコアリングせず、先に計算する
最も重要なアーキテクチャ判断:レコメンドはリクエストの最中ではなく、前もって計算される。
モデルはユーザーごとに一度だけ走ります——プロファイル登録時に属性をスコアリングし、ユーザーに紐づく嗜好プロファイルとして保存します。その後、スケジュールされたECSジョブが組み立てを担います:ユーザーを走査し、候補集合を作り(地理と予算のフィルタで数千件をユーザーごとに絞り込む)、保存済みプロファイルと突合し、ランク付き結果をMySQLのレコメンドログに書き込む。APIティアも——チャットボットも——そのログへのインデックス付き読み取りとしてレコメンドを提供し、キャッシュミス時のみ保存済みプロファイルから再計算します。推論サービスは読み取り経路に一切座っていません。
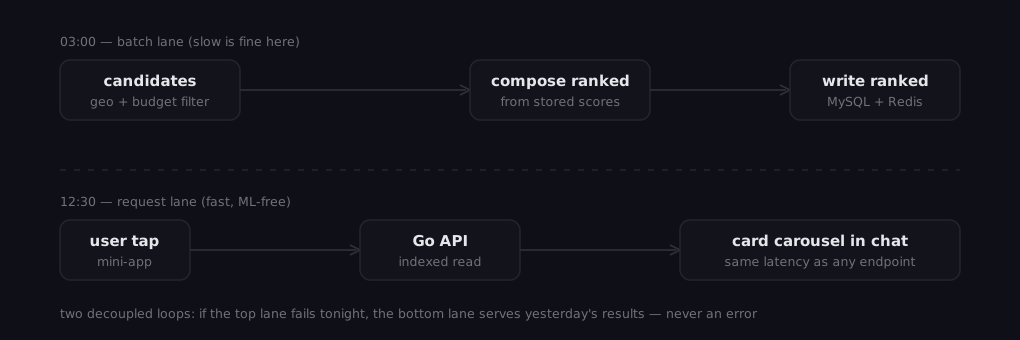
リアルタイムスコアリングはより洗練されて聞こえる選択肢でした。しかし事前計算は、ここで問われる全軸で勝ちます:
- 鮮度はそれを必要としなかった。 物件在庫は秒単位ではなく日単位で変わります。週次・隔週のレコメンドパスに、夜間のマスターデータ更新+スコアリングパスを重ねれば、十分に新鮮でした。
- 障害の隔離。 推論サービスが落ちればプロファイル更新は劣化します——しかしレコメンドは保存済み結果から提供され続け、ユーザーはエラーを見ません。リクエスト経路設計なら、ML障害はプロダクト障害になります。
- プッシュ通知はどのみちバッチを必要とする。 キャンペーンパイプライン——「あなたのプロファイルに合う新着物件」——はユーザーを走査し、スコアを確認し、メッセージを送ります。それはまさにバッチジョブです。配信経路にその出力を共有させることで、レコメンドの真実の源が2つに割れてドリフトする代わりに、1つになりました。
LINEという配信レイヤー
チャットプラットフォームはブラウザではなく、ブラウザのように扱えば不格好なプロダクトができます。効いた部品:
- LIFFミニアプリ — フォーム的・リスト的なものすべてに:検索、フィルタ、お気に入り、予約。バックエンドから見ればプラットフォームのIDトークンを持ってRESTを叩く普通のWebクライアントです。トークンを検証し、プラットフォームのユーザーを自分のユーザーにマッピングし、あとは通常どおり。
- Flex Messageカルーセル — チャット内のレコメンド配信に。レコメンドのプッシュはリンクではなく、会話の中でネイティブに描画されるスワイプ可能なカードの束で、各カードがLIFFの詳細ビューにディープリンクします。クリック率はこの描画にかかっています。
- リッチメニュー+チャットボットフロー — ナビゲーションとして。ユーザーは何もタイプせずにすべての機能へ到達できます。
- レート制限されたプッシュキャンペーン。 メッセージングAPIには従量の上限があり、通知スパムはユーザーを容赦なく離脱させます。キャンペーンバッチはスロットルされ、直近の送信と重複排除され、ユーザーごと・期間ごとに上限があります。チャットプラットフォームでは、送りすぎはチャネルそのものを失う最速の方法です——ブロックされれば、以後のすべてのレコメンドが一緒に消えます。
APIティアからの運用の学びをひとつ:Goの並行性があると、つい分散させたくなります——スコア確認はこちら、お気に入り参照はあちら。あの層の本番問題の多くは、理由のない並列化から来たnil安全性とロック競合のバグでした。Redisを前に置いた退屈な逐次ハンドラーのほうが、賢いハンドラーより速く、しかもデバッグしやすかったのです。
何が効いたのか
振り返ると、このシステムの品質はモデルではなく3つの境界から来ています:
- 推論はAPI契約を持つサービスである — モデルはプロダクト層に知られることなく、再学習も、差し替えも、A/Bも可能。
- 提供はスコアリングから分離されている — バッチ事前計算により、ユーザー向けレイテンシとMLの可用性は独立した問題になる。
- チャネルは一級の制約である — レコメンドは、人々が実際にそれを受け取る形(チャットスレッドの中のカードカルーセル)のために設計され、汎用APIへの後付けではない。
モデルは仕事の2割ほどでした。残りの8割は、前もって計算されたスコアが昼休みにタップされるカードになること——そしてその2つの瞬間の間の何ものも、プロダクトを落とせないことを保証する仕事でした。
この記事は同じプラットフォームを扱う短いシリーズの起点です:UIがチャットスレッドであるプロダクトを作る、ブロックされなかったプッシュパイプライン、実行計画には現れないロック競合。